

پژوهش مصرف انرژی هوش مصنوعی؛ فاصله پشتو و انگلیسی در سه مدل زبانی
- مجموعه: اخبار تکنولوژی
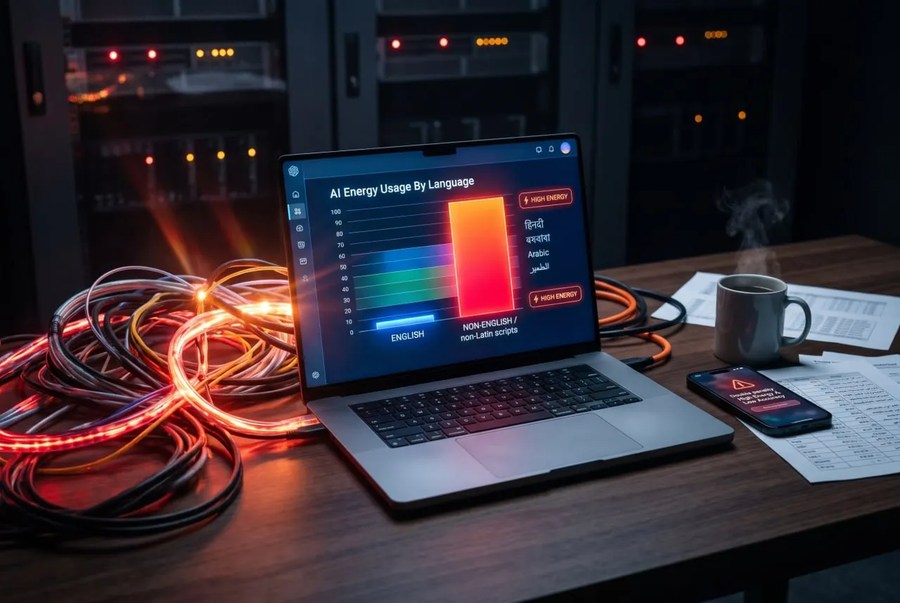
به گزارش دیجیاتو، پژوهشی درباره مصرف انرژی مدلهای زبانی چندزبانه نشان میدهد زبان درخواست و پاسخ میتواند در مصرف برق پردازش اثر چشمگیری داشته باشد. در مطالعه «شکاف زبان و انرژی»، برای یک مجموعه ثابت از درخواستها، تولید پاسخ انگلیسی حدود ۱۷٫۶ کیلوژول و تولید پاسخ پشتو حدود ۳۱۴۷ کیلوژول انرژی مصرف کرد. بیشترین فاصله ثبتشده در این مقایسه حدود ۱۷۹ برابر بود. این رقم نسبت دو زبان در شرایط آزمایش است و به همه متنهای غیرانگلیسی یا هر مدل زبانی تعمیم داده نمیشود.
آزمایش چگونه انجام شد؟
پژوهشگران سه مدل متنباز Qwen 3 علیبابا، Gemma 3 گوگل و Llama 3.1 متا را با چارچوب اندازهگیری ML.Energy ارزیابی کردند. بخشی از ارزیابی از مجموعه Belebele استفاده میکرد که برای سنجش درک مطلب در ۱۲۲ گونه زبانی تهیه شده است. پرسشهای چندگزینهای، مسائل ریاضی و درخواستهای باز در مقایسه حضور داشتند. هر سه مدل در میانگین آزمایش برای انگلیسی انرژی کمتری مصرف کردند و اختلاف میان زبانها در اندازههای مختلف مدل و روی سختافزارهای متفاوت هم مشاهده شد.
تعداد توکن و انرژی هر توکن
مدل زبانی پیش از پردازش، متن را به توکنها تقسیم میکند. اجزای نوشتاری بعضی زبانها در توکنساز مدل بیشتر از عبارتهای هممعنای انگلیسی شکسته میشوند. این موضوع در برخی زبانهای دارای خط ترکیبی، از جمله هندی و نپالی، و همچنین در زبانهایی که داده کمتری برای آموزش مدل داشتهاند اهمیت پیدا میکند. خروجی طولانیتر از نظر توکن و تفاوت انرژی لازم برای پردازش هر توکن میتوانند همزمان رخ دهند.
در مقاله، تفاوت انرژی به ازای هر توکن خروجی تا ۸٫۳ برابر گزارش شده است. پردازش توکنهای بیشتر نیز حافظه لازم را بالا میبرد و میتواند مدل را ناچار کند کار را در دستههای کوچکتر انجام دهد. تفاوت در تعداد توکن برای خدماتی که هزینه استفاده را بر اساس توکن محاسبه میکنند میتواند مستقیماً بر صورتحساب کاربر اثر بگذارد.
پیامد اختلاف برای کاربران و ارائهدهندگان
محققان میان مصرف بالاتر و دقت پایینتر در بخشی از زبانهای بررسیشده نیز همزمانی دیدند. اگر مدل برای زبانی توکن بیشتری بسازد و پاسخهای کمدقتتری تولید کند، هزینه پردازش بالا میرود و نتیجه برای کاربر همان زبان مطلوبیت کمتری دارد. در برآورد نقلشده در گزارش، حدود ۵٫۲ میلیارد نفر برای تولید متن به زبان اول خود در گروهی قرار میگیرند که مصرف انرژی آن بیش از دو برابر انگلیسی است.
از راهکارهای مطرحشده برای کاهش این فاصله میتوان به بهینهسازی مدل برای زبانهای بیشتر، استفاده از مدل تخصصی یک زبان و ترجمه درخواست پیش از پردازش اشاره کرد. نویسندگان مطالعه پیشنهاد میکنند میزان مصرف انرژی نیز در کنار دقت در گزارش ارزیابی مدلهای چندزبانه بیاید تا اثر زبان، سختافزار و نوع درخواست جداگانه قابل مقایسه باشد.